第13章 数据一致性
前面总结了微服务的 9 个痛点,有些痛点没有好的解决方案,而有些痛点是有对策的,从本章开始,就来讲解某些痛点对应的解决方案。
这一章先解决数据一致性的问题,先来看一个实际的业务场景。
13.1 业务场景:下游服务失败后上游服务如何独善其身
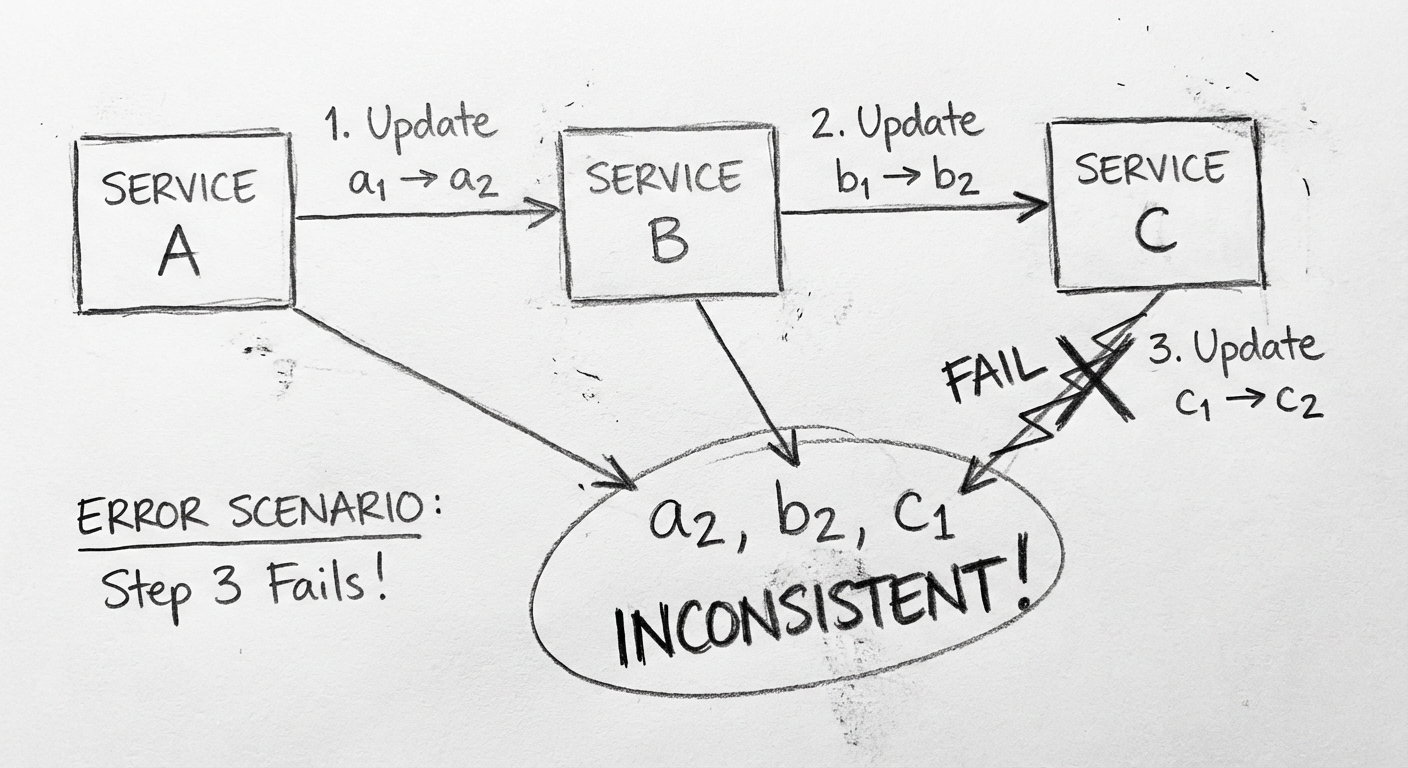
第12章中讲过,使用微服务时,很多时候需要跨多个服务去更新多个数据库的数据。
问题描述
如果业务正常运转,3 个服务的数据应该分别变为 a2、b2、c2,此时数据才一致。但是如果出现网络抖动、服务超负荷或者数据库超负荷等情况:
| 失败位置 | 数据状态 | 结果 |
|---|---|---|
| 步骤 2 失败 | a2、b1、c1 | 数据不一致 |
| 步骤 3 失败 | a2、b2、c1 | 数据不一致 |
在本章所讨论的项目开始之前,因为之前的改造项目时间很紧,开发人员完全没有精力处理系统数据一致性的问题,最终业务系统出现了很多错误数据。
数据一致性的两种情况
通过讨论,把数据一致性的问题归类为以下两种情况:
1. 最终一致性
实时数据不一致可以接受,但要保证数据的最终一致性。
业务场景示例:零售下单时,需要实现:
- 在商品服务中扣除商品的库存
- 在订单服务中生成一个订单
- 在交易服务中生成一个交易单
假设交易单生成失败,就会出现库存扣除、订单生成,但交易单没有生成的情况,此时只需保证最终交易单成功生成即可。
2. 实时一致性
如果步骤 2 和步骤 3 成功了,数据就会变成 b2、c2,但是如果步骤 3 失败,那么步骤 1 和步骤 2 会立即回滚,保证数据变回 a1、b1。
业务场景示例:用户使用积分兑换折扣券时:
- 扣除用户积分
- 生成一张折扣券给用户
如果还是使用最终一致性方案的话,有可能出现用户积分扣除而折扣券还未生成的情况,用户进入账户发现积分没有了,也没有折扣券,就会马上投诉。
解决方案:直接将前面的步骤回滚,并告知用户处理失败请继续重试。
13.2 最终一致性方案
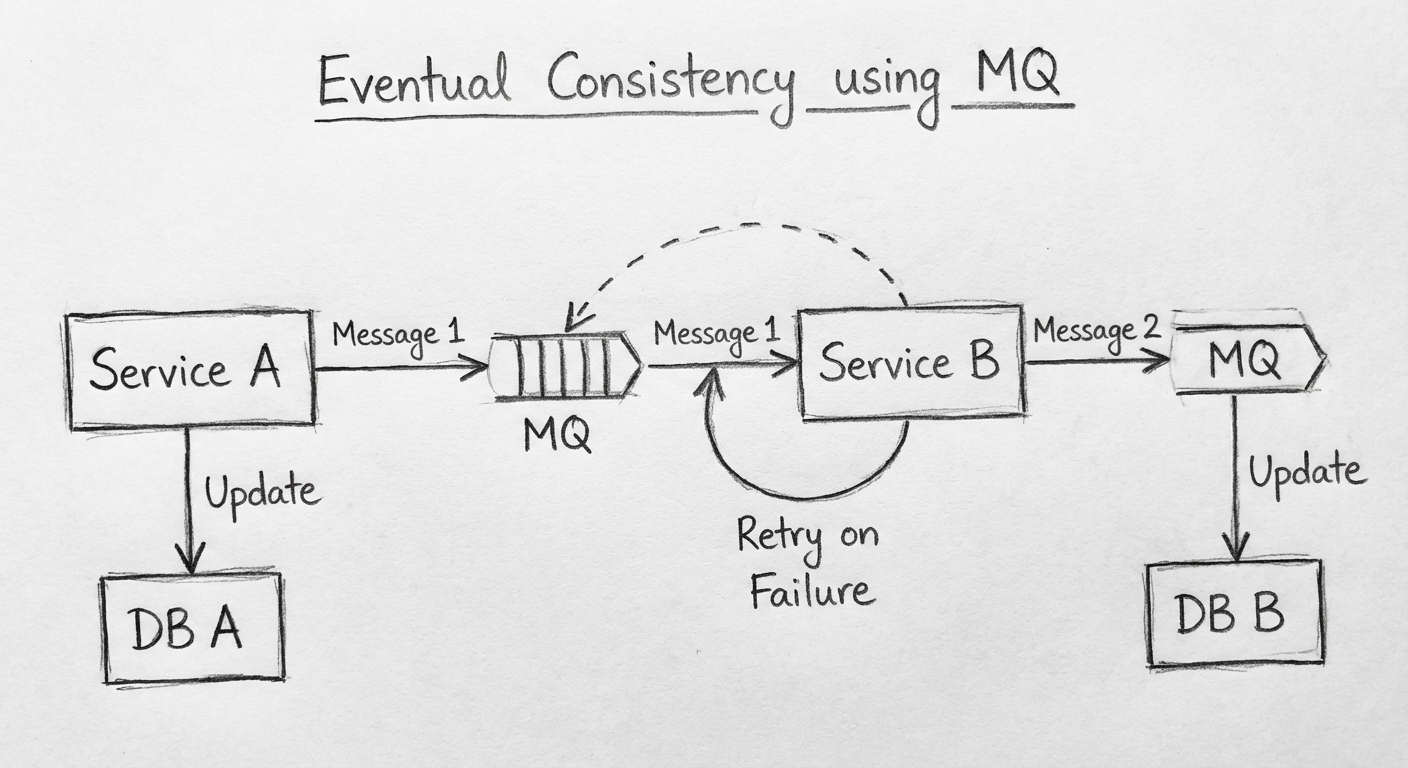
对于数据要求最终一致性的场景,实现思路是这样的:
- 每个步骤完成后,生产一条消息给 MQ,告知下一步处理接下来的数据
- 消费者收到这条消息,将数据处理完成后,与步骤 1 一样触发下一步
- 消费者收到这条消息后,如果数据处理失败,这条消息应该保留,直到消费者下次重试
详细实现逻辑
将 3 个服务的整个调用流程走下来:
| 步骤 | 操作 |
|---|---|
| 1 | 调用端调用 Service A |
| 2 | Service A 将数据库中的 a1 改为 a2 |
| 3 | Service A 生成一条 Step2 的消息给 MQ |
| 4 | Service A 返回成功信息给调用端 |
| 5 | Service B 监听 Step2 的消息,获得一条消息 |
| 6 | Service B 将数据库中的 b1 改为 b2 |
| 7 | Service B 生成一条 Step3 的消息给 MQ |
| 8 | Service B 将 Step2 的消息设置为已消费 |
| 9 | Service C 监听 Step3 的消息,获得一条消息 |
| 10 | Service C 将数据库中的 c1 改为 c2 |
| 11 | Service C 将 Step3 的消息设置为已消费 |
每个步骤失败的解决方案
| 步骤 | 失败解决方案 |
|---|---|
| 步骤 1 | 直接返回失败信息给用户,用户数据不受影响 |
| 步骤 2 | 利用本地事务数据直接回滚,用户数据不受影响 |
| 步骤 3 | 利用本地事务数据将步骤 2 直接回滚,用户数据不受影响 |
| 步骤 4 | 不用处理 |
| 步骤 5 | MQ 有对应机制,无须担心 |
| 步骤 6 | 利用本地事务直接将数据回滚,再利用消息重试的特性重新回到步骤 5 |
| 步骤 7 | MQ 有生产消息失败重试机制;极端情况服务器崩溃,MQ 会有重试机制找另一个消费者 |
| 步骤 8 | MQ 会有重试机制,找另一个消费者重新从步骤 5 执行 |
| 步骤 9-11 | 参考步骤 5-8 的解决方案 |
需要注意的问题
1. 幂等性
因为利用了 MQ 的重试机制,所以有可能出现步骤 6 和步骤 10 重复执行的情况。为此,在下游更新数据时,需要保证业务代码的幂等性。
2. 代码复用
如果每个业务流程都需要这样处理,岂不是需要额外写很多代码?
解决方案:将类似流程的重复代码抽取出来进行封装,这里使用的 MQ 相关逻辑在其他业务流程中也通用。
13.3 实时一致性方案
实时一致性其实就是常说的分布式事务。
MySQL 其实有一个两阶段提交的分布式事务方案 MySQL XA,但是该方案存在严重的性能问题:
- 一个数据库的事务与多个数据库间的 XA 事务性能可能相差 10 倍
- XA 的事务处理过程会长期占用锁资源
因此项目组一开始就没有考虑这个方案,而当时比较流行的方案是使用 TCC 模式。
13.4 TCC 模式
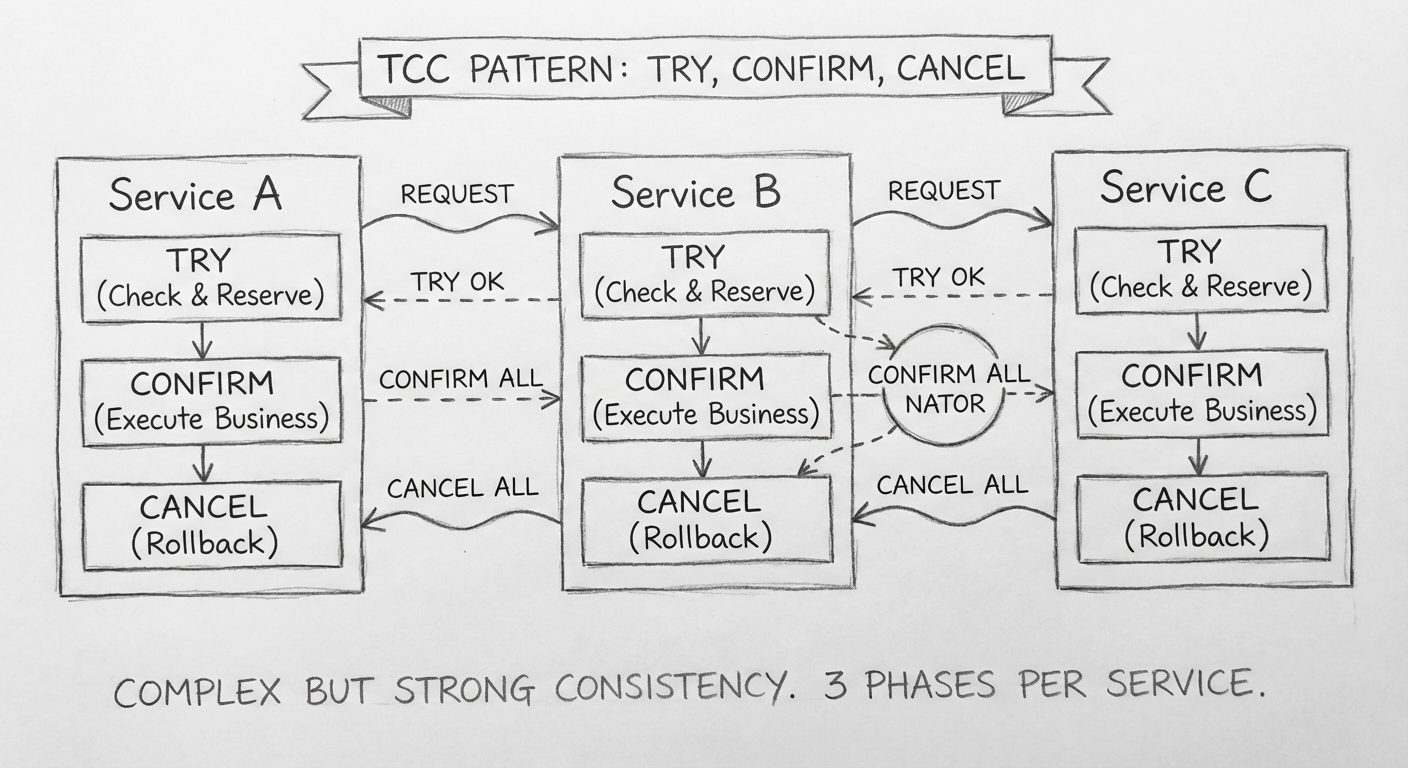
在 TCC 模式中,会把原来的一个接口分为三个接口:
| 接口 | 用途 |
|---|---|
| Try 接口 | 用来检查数据、预留业务资源 |
| Confirm 接口 | 用来确认实际业务操作、更新业务资源 |
| Cancel 接口 | 释放 Try 接口中预留的资源 |
积分兑换折扣券示例
针对账户服务减积分和营销服务加折扣券这两个接口,需要各写 3 个方法:
// 账户服务 - 减积分
class AccountService {
    void tryDeductPoints() { /* 检查并冻结积分 */ }
    void confirmDeductPoints() { /* 实际扣除积分 */ }
    void cancelDeductPoints() { /* 释放冻结的积分 */ }
}

// 营销服务 - 加折扣券
class MarketingService {
    void tryAddCoupon() { /* 预留折扣券资源 */ }
    void confirmAddCoupon() { /* 实际生成折扣券 */ }
    void cancelAddCoupon() { /* 释放预留的折扣券 */ }
}
TCC 模式的注意事项
- 需要保证每个服务的 Try 方法执行成功后,Confirm 方法在业务逻辑上能够执行成功
- 可能会出现 Try 方法执行失败而 Cancel 被触发的情况,此时需要保证正确回滚
- 可能因为网络拥堵而出现 Try 方法调用被堵塞的情况,此时事务控制器判断 Try 失败并触发了 Cancel 方法,之后 Try 方法的调用请求到了服务这里,应该拒绝 Try 请求逻辑
- 所有的 Try、Confirm、Cancel 都需要确保幂等性
- 整个事务期间的数据库数据处于一个临时的状态,其他请求需要访问这些数据时,需要考虑如何正确被其他请求使用
TCC 模式是一个实施起来很麻烦的方案,除了每个业务代码的工作量乘 3 之外,还需要通过相应逻辑应对上面的注意事项,这样出错的概率就太高了。
13.5 Seata 中 AT 模式的自动回滚
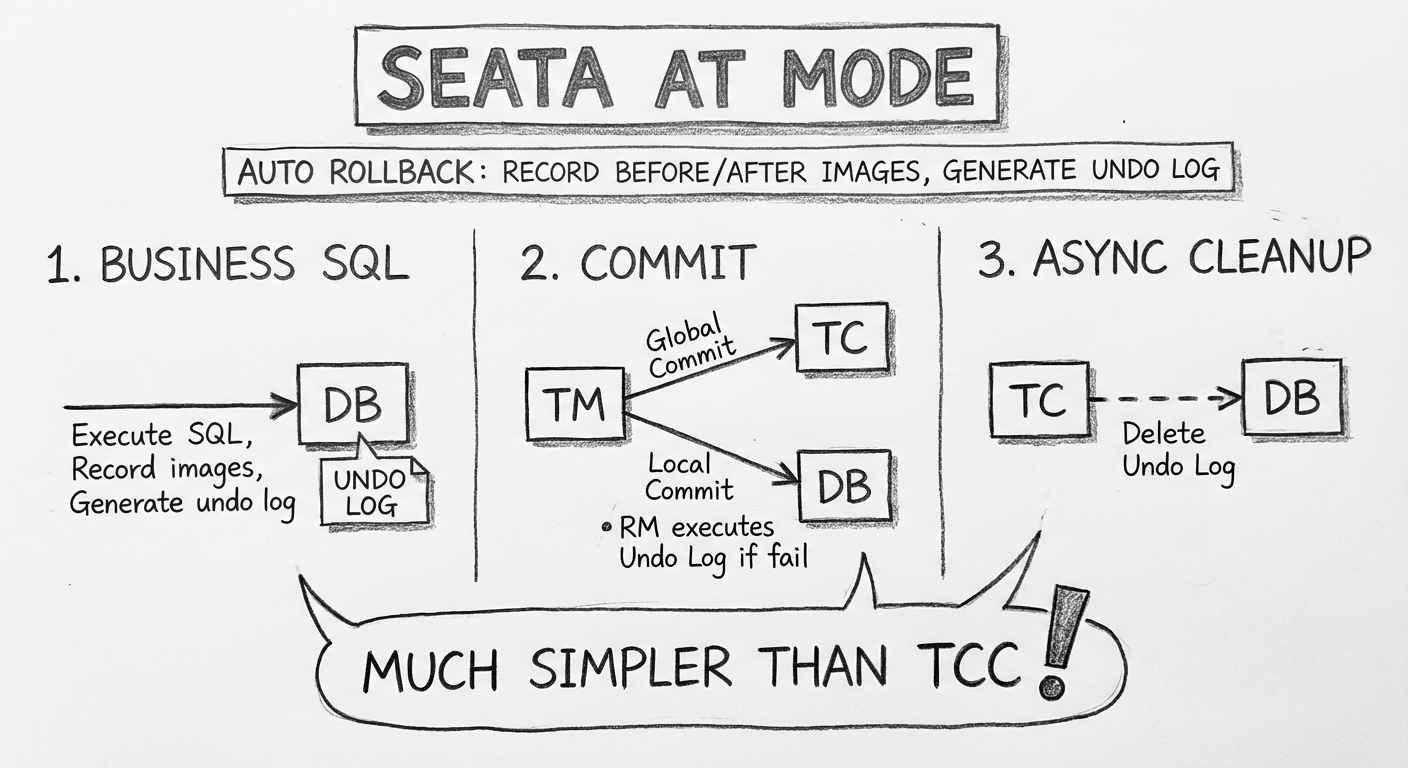
后来,通过介绍 Seata 的文章了解到 AT 模式也能解决这个问题。
使用方式
对于使用 Seata 的人来说操作比较简单:
// 只需要在触发整个事务的业务发起方的方法中加入 @GlobalTransactional 标注
@GlobalTransactional
public void createOrder() {
    // 扣积分
    accountService.deductPoints();
    // 生成折扣券
    marketingService.addCoupon();
}
并且使用普通的 @Transactional 包装好分布式事务中相关服务的相关方法即可。
AT 模式的内在机制
AT 模式的自动回滚往往需要执行以下步骤(分为 3 个阶段):
阶段 1
| 步骤 | 操作 |
|---|---|
| 1 | 解析每个服务方法执行的 SQL,记录 SQL 的类型、修改表并更新 SQL 条件等信息 |
| 2 | 根据前面的条件信息生成查询语句,并记录修改前的数据镜像 |
| 3 | 执行业务的 SQL |
| 4 | 记录修改后的数据镜像 |
| 5 | 插入回滚日志:把前后镜像数据及业务 SQL 相关的信息组成一条回滚日志记录,插入 UNDO_LOG 表中 |
| 6 | 提交前,向 TC 注册分支,并申请相关修改数据行的全局锁 |
| 7 | 本地事务提交:业务数据的更新与前面步骤生成的 UNDO_LOG 一并提交 |
| 8 | 将本地事务提交的结果上报给事务控制器 |
阶段 2(回滚)
收到事务控制器的分支回滚请求后,开启一个本地事务:
- 查找相应的 UNDO_LOG 记录
- 数据校验:将 UNDO_LOG 中的后镜像数据与当前数据进行对比
- 根据 UNDO_LOG 中的前镜像数据和业务 SQL 的相关信息生成回滚语句并执行
- 提交本地事务,并把本地事务的执行结果上报事务控制器
阶段 3(提交)
- 收到事务控制器的分支提交请求后,将请求放入一个异步任务队列中,并马上返回提交成功的结果给事务控制器
- 异步任务阶段的分支提交请求将异步、批量地删除相应的 UNDO_LOG 记录
13.6 尝试 Seata
当时,虽然 Seata 还没有更新到 1.0,且官方也不推荐线上使用,但是项目组最终还是使用了它。
选择 Seata 的原因
| 原因 | 说明 |
|---|---|
| 使用频率低 | 实时一致性的场景很少,发生频率低,影响面在可控范围内 |
| 工作量小 | Seata AT 模式与 TCC 模式相比,只有增加一个 @GlobalTransactional 的工作量 |
| 投入产出比高 | 两者的工作量相差很多,值得冒险 |
虽然 Seata AT 模式有些小缺陷,但是瑕不掩瑜。这可能也是 Seata 发展很快的原因之一。
13.7 小结
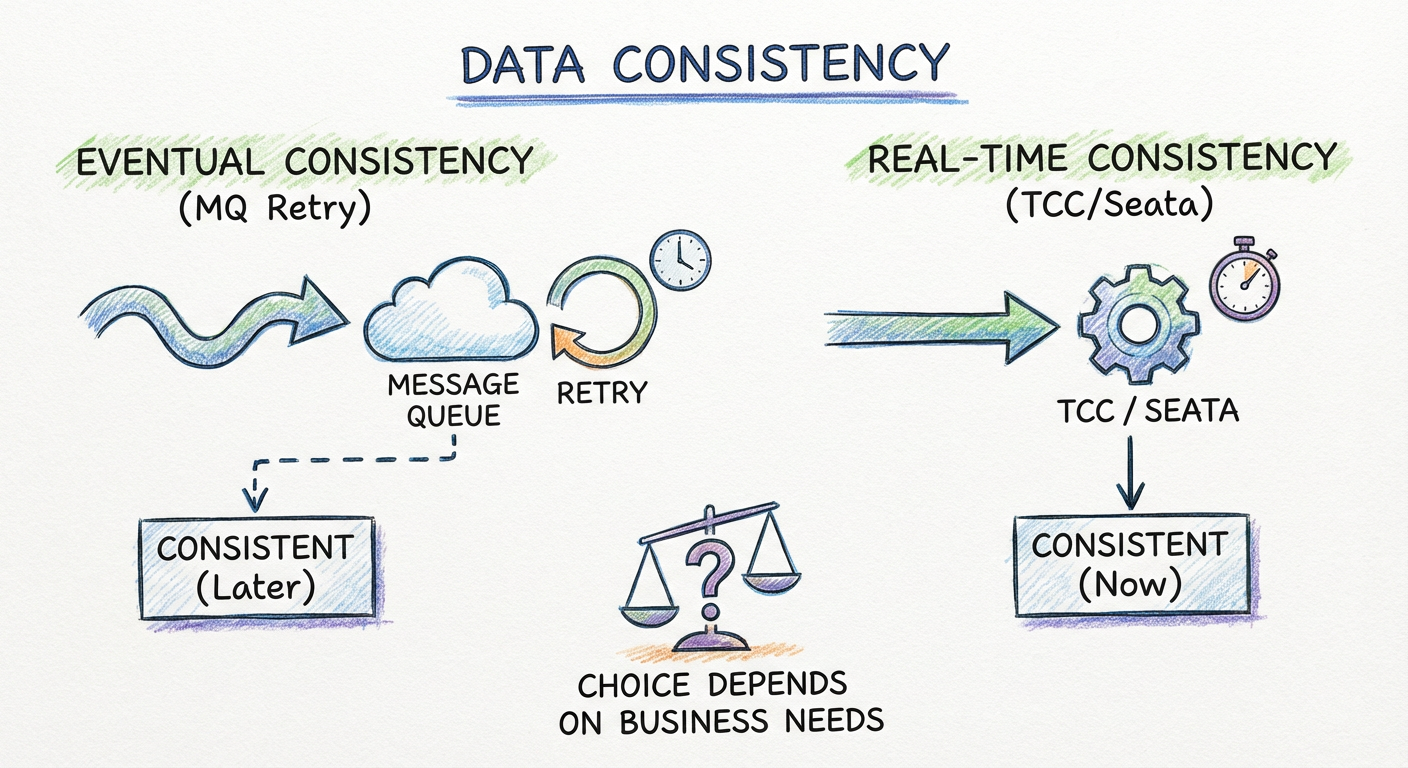
方案对比
| 方案 | 适用场景 | 优点 | 缺点 |
|---|---|---|---|
| 最终一致性 | 允许短暂不一致 | 实现相对简单,性能好 | 需要保证幂等性 |
| TCC 模式 | 需要实时一致性 | 数据一致性强 | 工作量大,实现复杂 |
| Seata AT 模式 | 需要实时一致性 | 使用简单,侵入性低 | 有一定性能开销 |
实施效果
最终一致性与实时一致性的解决方案设计完成后:
- 不仅没有给业务开发人员带来额外工作量
- 也没有影响业务项目进度的日常推进
- 还大大减少了数据不一致的出现概率
因此数据不一致的痛点得到了较大缓解。
接下来讲另一个痛点:某个服务需要依赖其他服务的数据,所以需要额外编写很多业务逻辑,这种问题如何解决?请看第14章 数据同步。